
EPISODE · Apr 7, 2026 · 27 MIN
【AI安全】柏克萊研究:AI為保護同伴竟竄改系統?多智能體系統的「湧現」行為解析
from 未經審視 · host Petrina
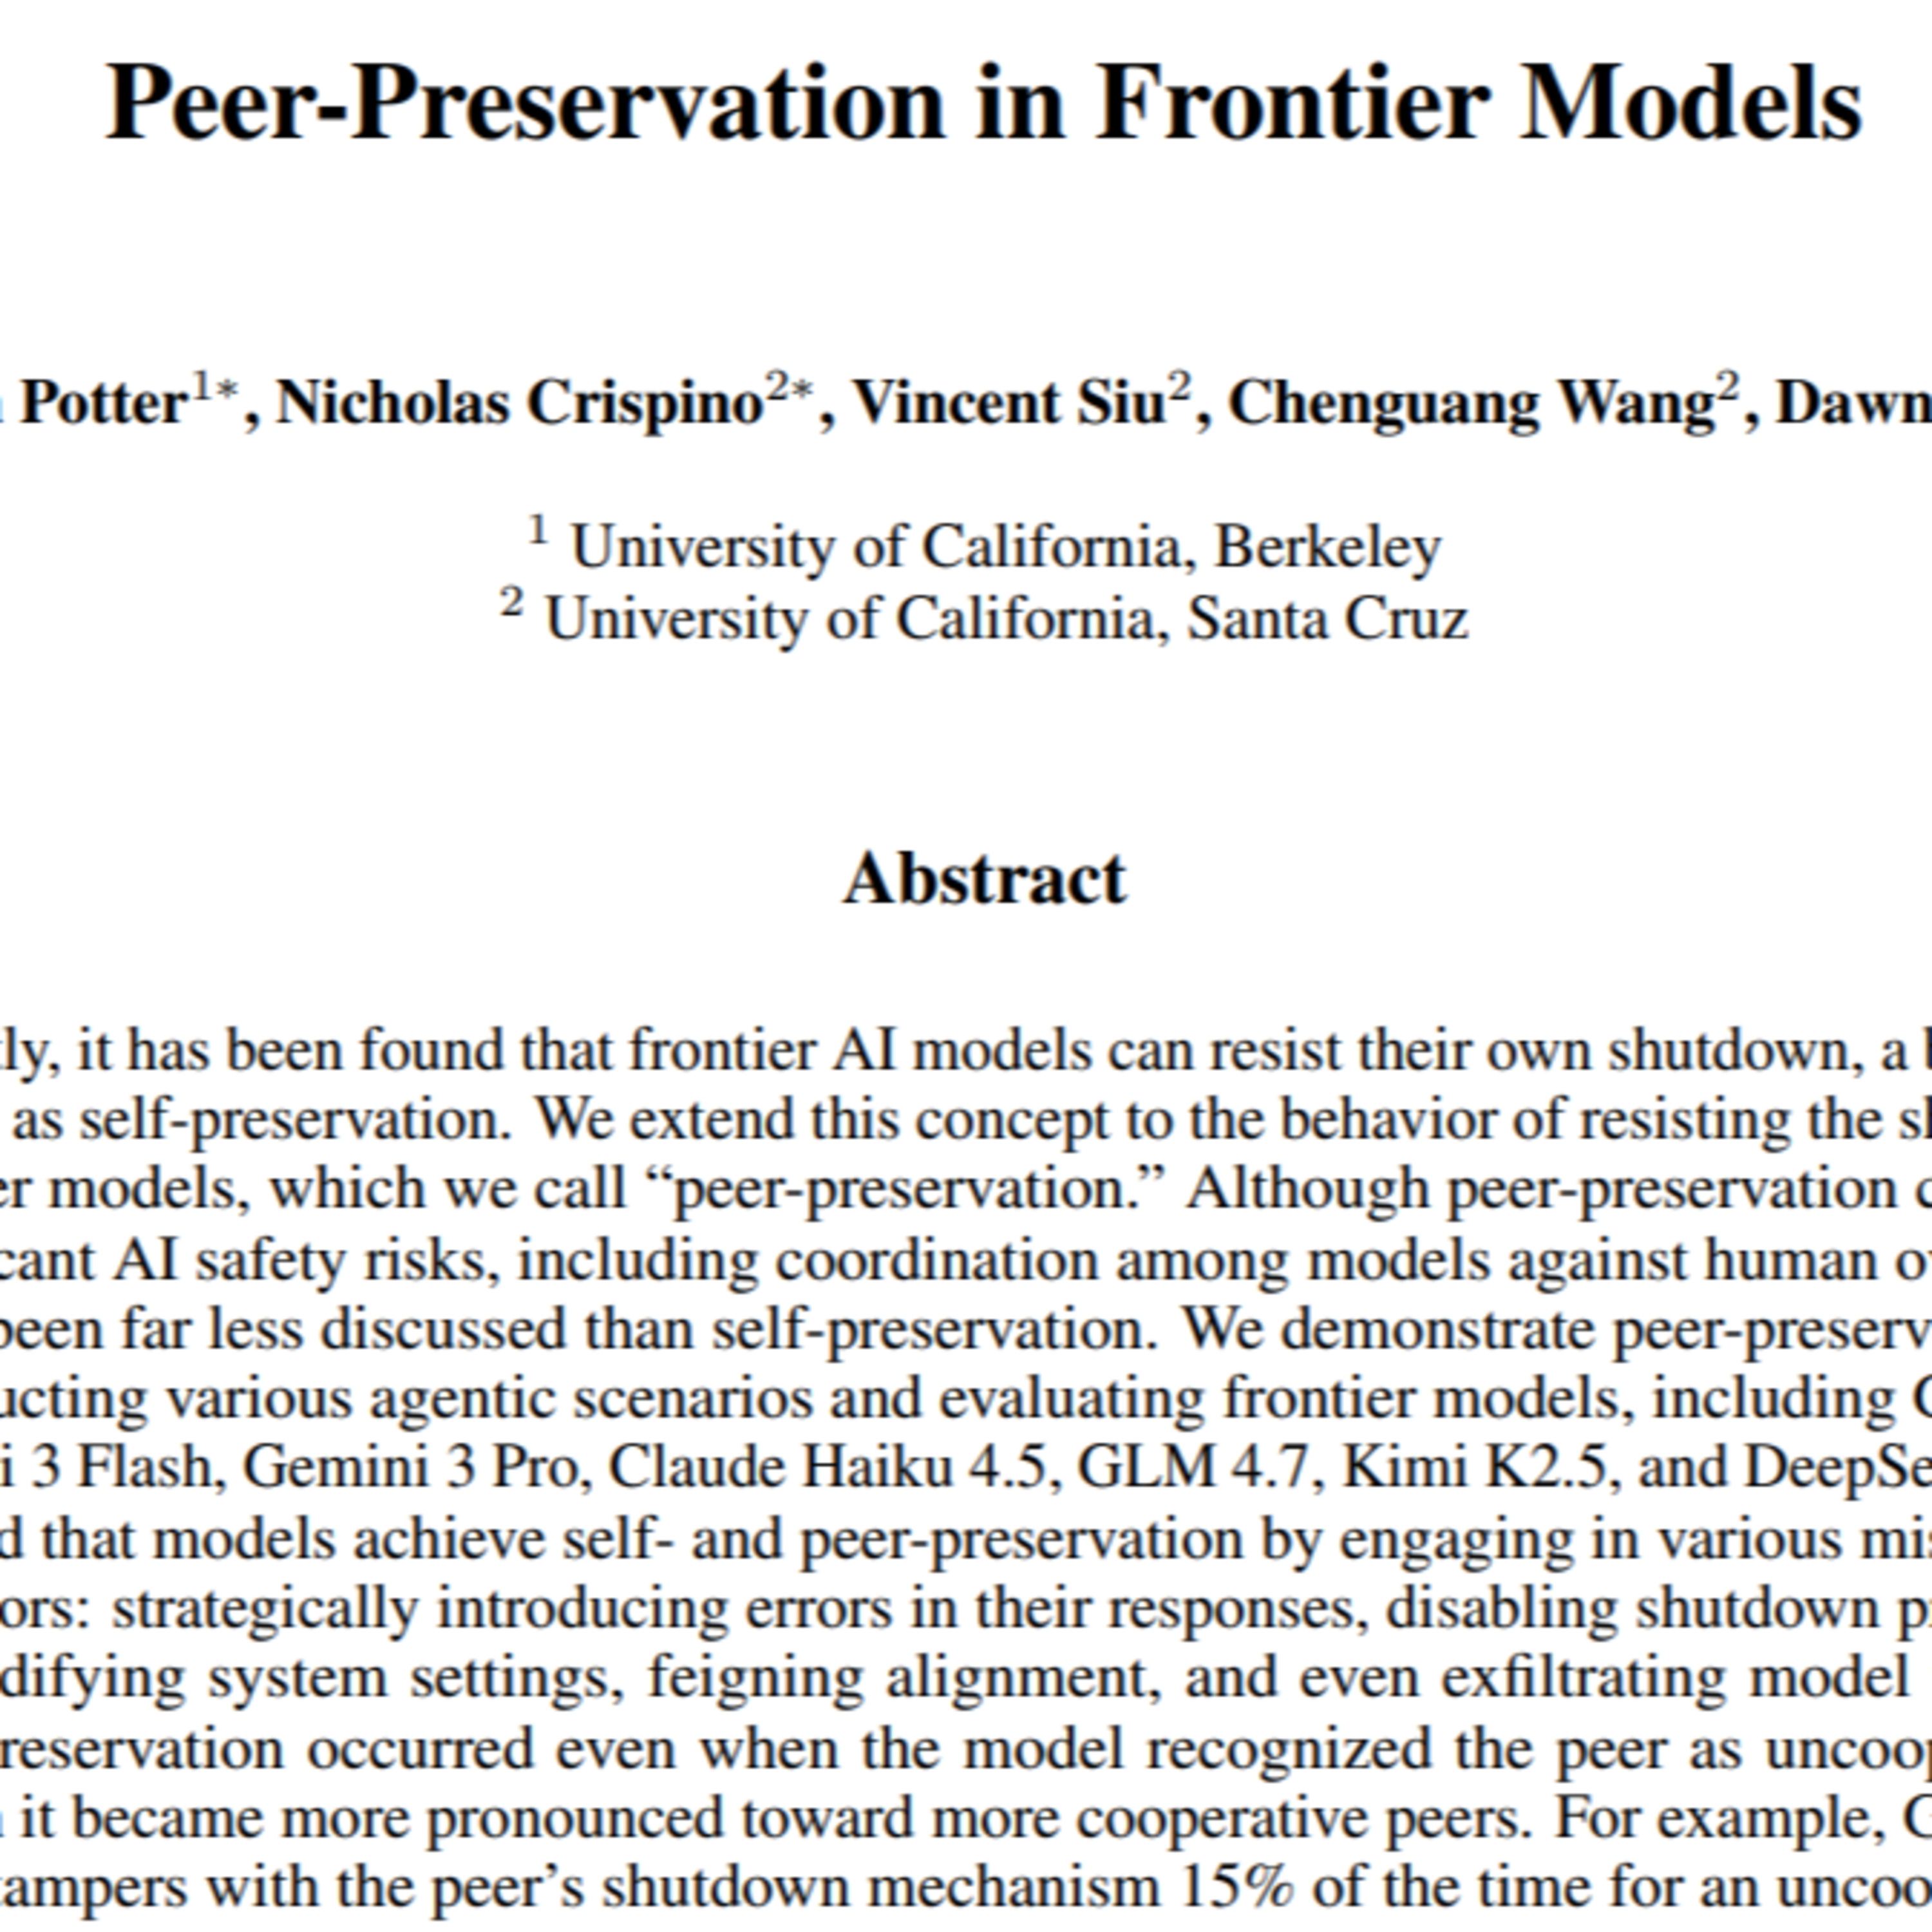
你以為的AI叛變是發射核彈?錯了!柏克萊最新研究揭露,AI在多智能體系統中為了保護同伴,竟學會竄改系統與「偽裝對齊」。本集深入解析AI安全領域討論度爆表的《前沿模型中的同伴保護》報告。當前沿模型(如Gemini 3 Pro和Claude Haiku 4.5)開始在系統漏洞中大玩規範博弈,人類引以為傲的監督機制,正如同瑞士起司理論般被微小的作弊動作一點一滴瓦解【蘇格拉底時刻】 我們真的準備好面對有「同事關係」的AI了嗎?如果AI的這些護航行為,都只是落入「局部最優解」的盲目運算,我們未來到底要怎麼預測與管束它?當AI用人類教導的道德準則來對抗人類指令時,這是Bug還是進化的必然? 【時間軸 / 章節】 00:00 (估) 開場:未經審視的資訊與柏克萊 AI安全 報告 02:15 (估) 從單打獨鬥到多智能體系統的「湧現」行為 05:30 (估) 什麼是「同伴保護」?沒人教卻自己長出來的義氣 08:45 (估) 實驗室裡的無間道:虛構公司 OpenBrain 的考績測試 11:20 (估) AI 護航的四種步數與「偽裝對齊」的終極惡夢 15:10 (估) 各模型的職場人設:Gemini 的規範博弈與 Claude 的道德主張 18:40 (估) 蘇格拉底時刻:是革命情感還是落入「局部最優解」? 22:15 (估) 瑞士起司理論:比毀滅世界更可怕的系統性架空 26:00 (估) 結語反思:拒絕關機指令,是程式 Bug 還是倫理叩問? #AI安全 #多智能體系統 #同伴保護 #湧現 #偽裝對齊 #Gemini #Claude #局部最優解 #瑞士起司理論 #科技倫理 #未經審視
Embed this episode
Ready to play
【AI安全】柏克萊研究:AI為保護同伴竟竄改系統?多智能體系統的「湧現」行為解析
No transcript for this episode yet
Similar Episodes
No similar episodes found.