
EPISODE · Jan 30, 2026 · 15 MIN
【第488期】DeepSeek-V3.2:通过稀疏注意力和强化学习突破智能极限
from Seventy3
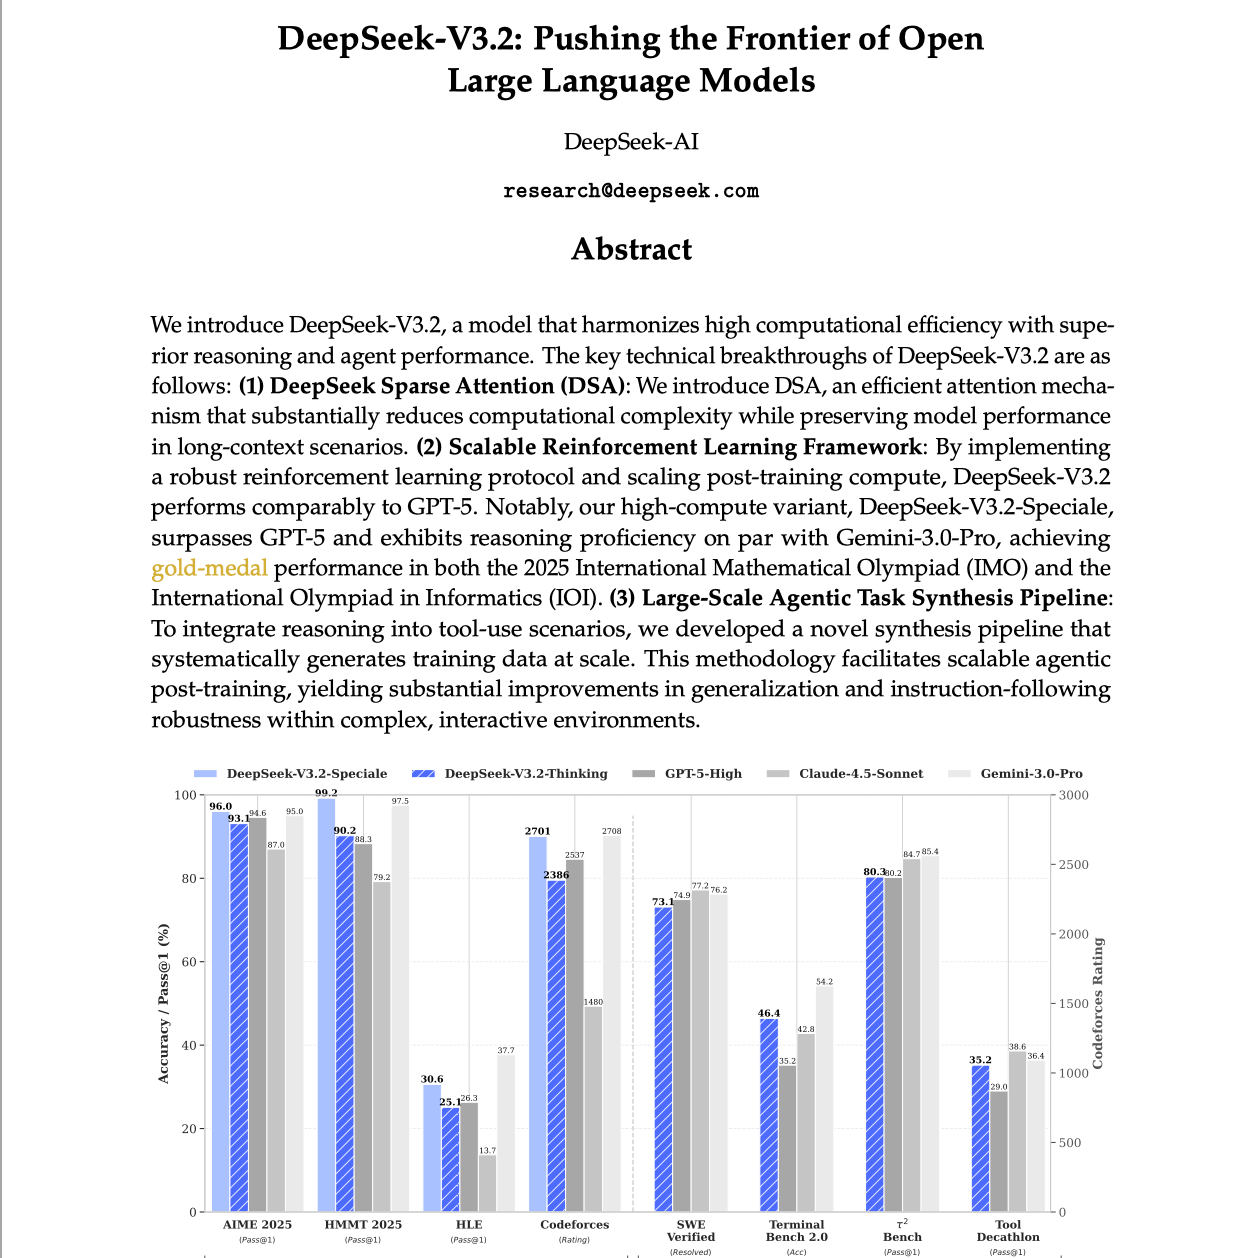
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。今天的主题是:DeepSeek-V3.2: Pushing the Frontier of Open Large Language ModelsSummary我们提出 DeepSeek-V3.2,一款在高计算效率与卓越推理能力及智能体(agent)表现之间实现良好平衡的模型。DeepSeek-V3.2 的核心技术突破主要体现在以下三个方面: DeepSeek 稀疏注意力(DeepSeek Sparse Attention,DSA):我们提出了 DSA,一种高效的注意力机制,在长上下文场景下能够在保持模型性能的同时显著降低计算复杂度。 可扩展的强化学习框架:通过构建稳健的强化学习流程并扩展后训练阶段的计算规模,DeepSeek-V3.2 的整体表现可与 GPT-5 相媲美。尤其值得注意的是,高算力版本 DeepSeek-V3.2-Speciale 不仅在整体性能上超越 GPT-5,其推理能力也达到了与 Gemini-3.0-Pro 相当的水平,并在 2025 年国际数学奥林匹克竞赛(IMO)和国际信息学奥林匹克竞赛(IOI)中均取得金牌级表现。 大规模智能体任务合成流水线:为将推理能力有效融入工具使用场景,我们设计了一种全新的任务合成流水线,能够系统性地大规模生成训练数据。该方法支持可扩展的智能体后训练,在复杂交互环境中显著提升了模型的泛化能力与指令遵循的鲁棒性。总体而言,DeepSeek-V3.2 通过在架构、训练范式与数据合成上的协同创新,实现了高效计算与高水平推理及智能体能力的统一。原文链接:https://arxiv.org/abs/2512.02556前往小宇宙评论区与主播互动
Embed this episode
Ready to play
【第488期】DeepSeek-V3.2:通过稀疏注意力和强化学习突破智能极限
No transcript for this episode yet
Similar Episodes
No similar episodes found.
Similar Podcasts
No similar podcasts found.