
EPISODE · Feb 15, 2026 · 20 MIN
【第504期】Engram:大语言模型条件存储与扩展查表机制
from Seventy3
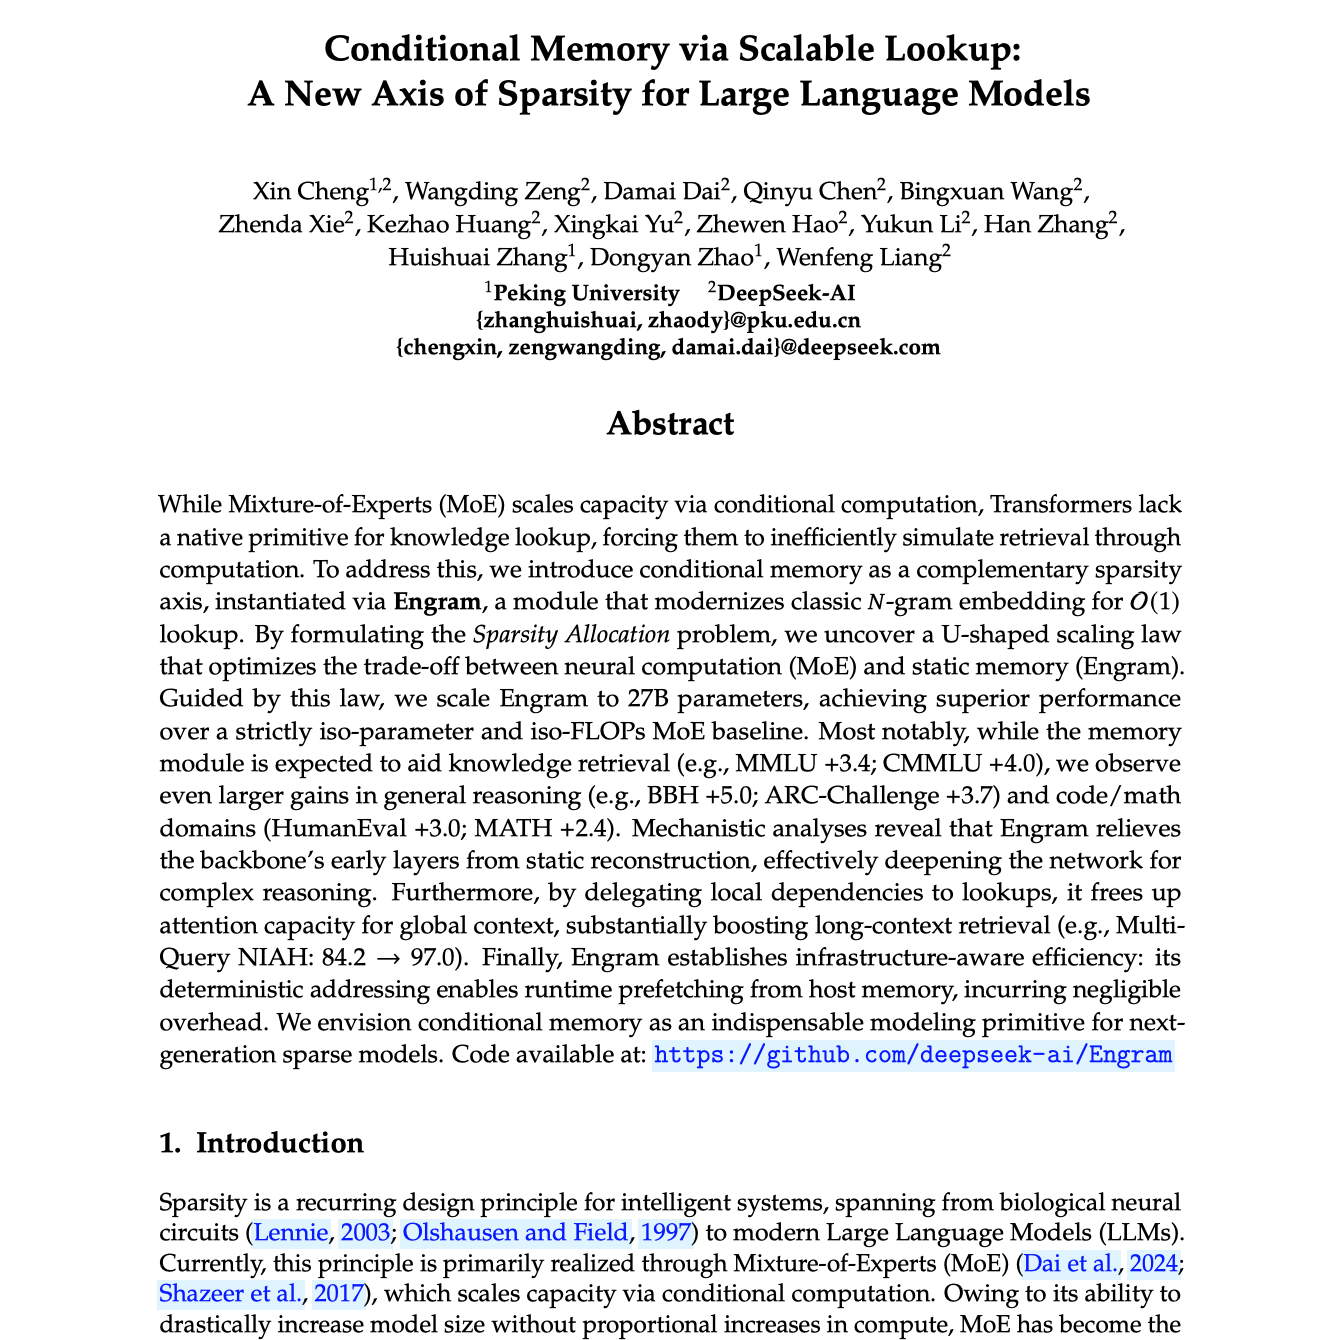
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。今天的主题是:Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language ModelsSummary尽管混合专家模型(Mixture-of-Experts,MoE)通过条件计算来扩展模型容量,Transformer 本身却缺乏用于知识查找的原生机制,只能通过计算来低效地“模拟”检索。为了解决这一问题,我们引入了条件记忆(conditional memory),作为一种互补的稀疏性维度,并通过 Engram 模块将其具体化。Engram 对经典的 N-gram 嵌入进行了现代化改造,实现了 O(1) 时间复杂度的查找。通过形式化稀疏性分配(Sparsity Allocation)问题,我们发现了一条 U 形缩放定律,用于优化**神经计算(MoE)与静态记忆(Engram)之间的权衡。在该定律的指导下,我们将 Engram 扩展至 270 亿参数,在严格参数量相同(iso-parameter)且计算量(FLOPs)相同(iso-FLOPs)**的 MoE 基线之上取得了更优性能。尤为值得注意的是,尽管记忆模块本被预期主要提升知识检索能力(如 MMLU +3.4;CMMLU +4.0),我们却在通用推理方面观察到更大的增益(如 BBH +5.0;ARC-Challenge +3.7),并且在代码与数学领域同样显著(HumanEval +3.0;MATH +2.4)。机制层面的分析表明,Engram 将静态重构的负担从主干网络的早期层中移除,实质上加深了网络,从而有利于复杂推理。此外,通过将局部依赖交由查表完成,它释放了注意力机制的容量,用于建模全局上下文,从而显著提升了长上下文检索能力(例如 Multi-Query NIAH:从 84.2 提升至 97.0)。最后,Engram 还实现了面向系统架构的高效性:其确定性的寻址方式支持在运行时从主机内存进行预取,几乎不引入额外开销。我们认为,条件记忆将成为下一代稀疏模型中不可或缺的建模原语。原文链接:https://arxiv.org/abs/2601.07372前往小宇宙评论区与主播互动
Embed this episode
Ready to play
【第504期】Engram:大语言模型条件存储与扩展查表机制
No transcript for this episode yet
Similar Episodes
No similar episodes found.
Similar Podcasts
No similar podcasts found.