
EPISODE · Feb 20, 2026 · 15 MIN
【第509期】GDPO:多奖励强化学习的解耦归一化策略优化
from Seventy3
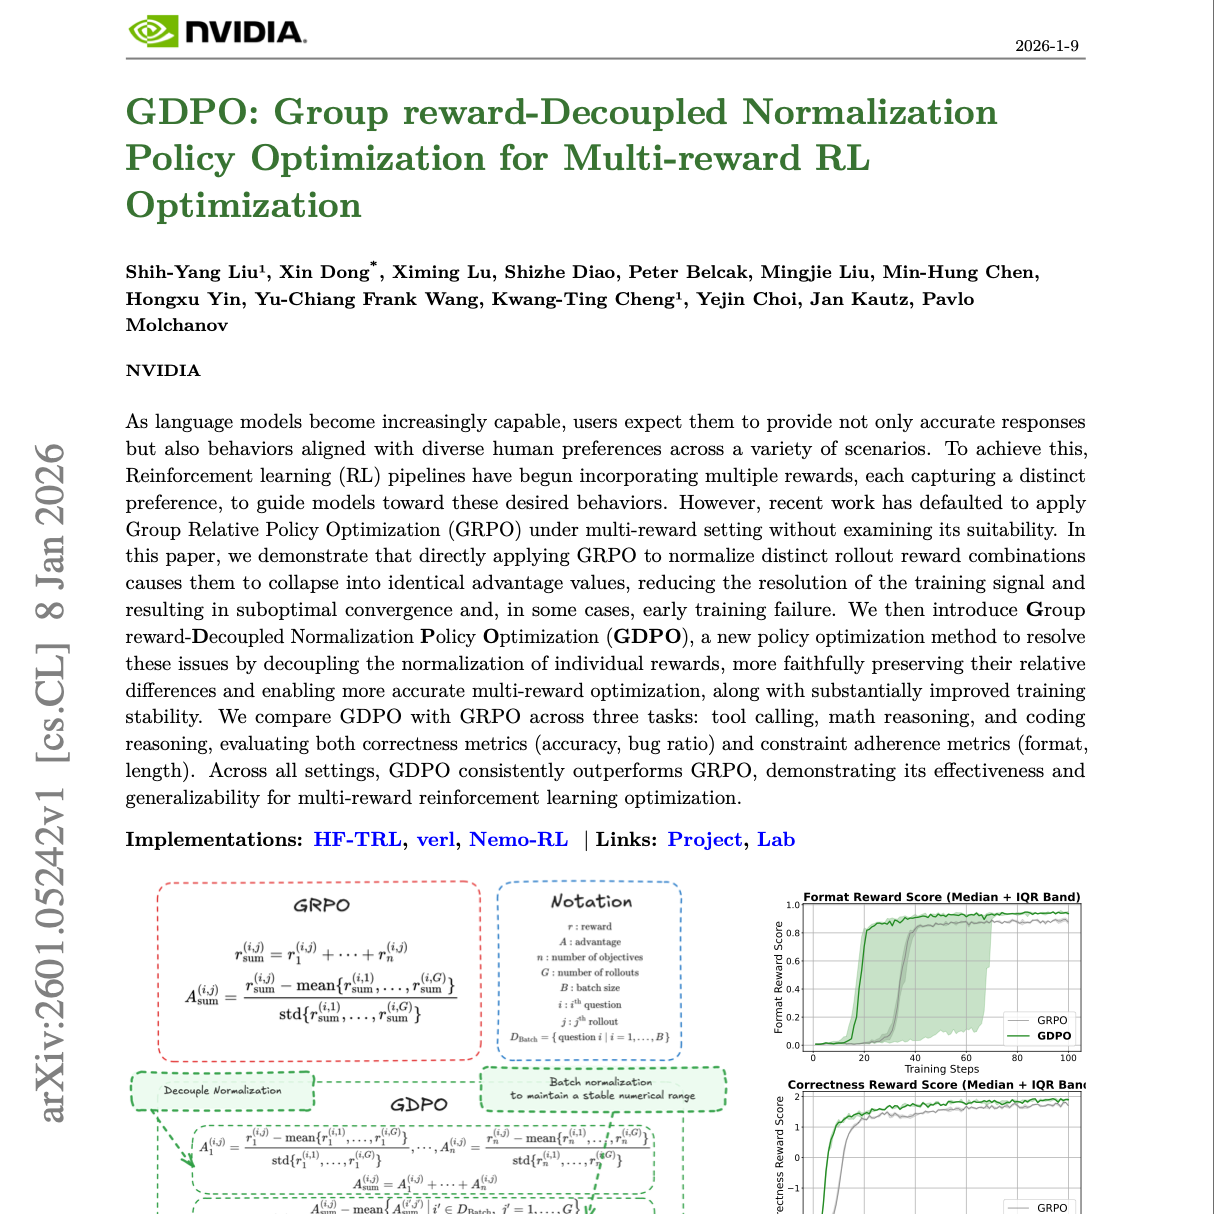
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。如果你有自己的论文要解读,或者推荐论文,请留言。今天的主题是:GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL OptimizationSummary随着语言模型能力的不断提升,用户不仅期望其提供准确的回答,还希望其行为能够在多种场景下符合多样化的人类偏好。为实现这一目标,强化学习(RL)流程开始引入多个奖励信号,每个奖励分别刻画一种不同的偏好,以引导模型朝着期望行为优化。然而,近期研究在多奖励设定下默认采用 Group Relative Policy Optimization(GRPO),却未对其适用性进行充分检验。本文表明,直接在多奖励场景中应用 GRPO,对不同 rollout 奖励组合进行归一化时,会导致这些组合坍缩为相同的优势值(advantage value),从而降低训练信号的分辨率,导致次优收敛,甚至在某些情况下出现训练早期失败。为解决上述问题,我们提出了 Group reward-Decoupled Normalization Policy Optimization(GDPO),一种新的策略优化方法。该方法通过对各个奖励的归一化过程进行解耦,更真实地保留奖励之间的相对差异,从而实现更精确的多奖励优化,并显著提升训练稳定性。我们在三个任务上对 GDPO 与 GRPO 进行了对比实验:工具调用、数学推理和代码推理。评估指标既包括正确性指标(如准确率、错误率),也包括约束遵循指标(如格式规范、长度控制)。在所有实验设置下,GDPO 均稳定优于 GRPO,验证了其在多奖励强化学习优化中的有效性与良好的泛化能力。原文链接:https://arxiv.org/abs/2601.05242前往小宇宙评论区与主播互动
Embed this episode
Ready to play
【第509期】GDPO:多奖励强化学习的解耦归一化策略优化
No transcript for this episode yet
Similar Episodes
No similar episodes found.
Similar Podcasts
No similar podcasts found.