
EPISODE · Mar 18, 2026 · 17 MIN
【第535期】SDPO:通过自我蒸馏强化丰富反馈学习
from Seventy3
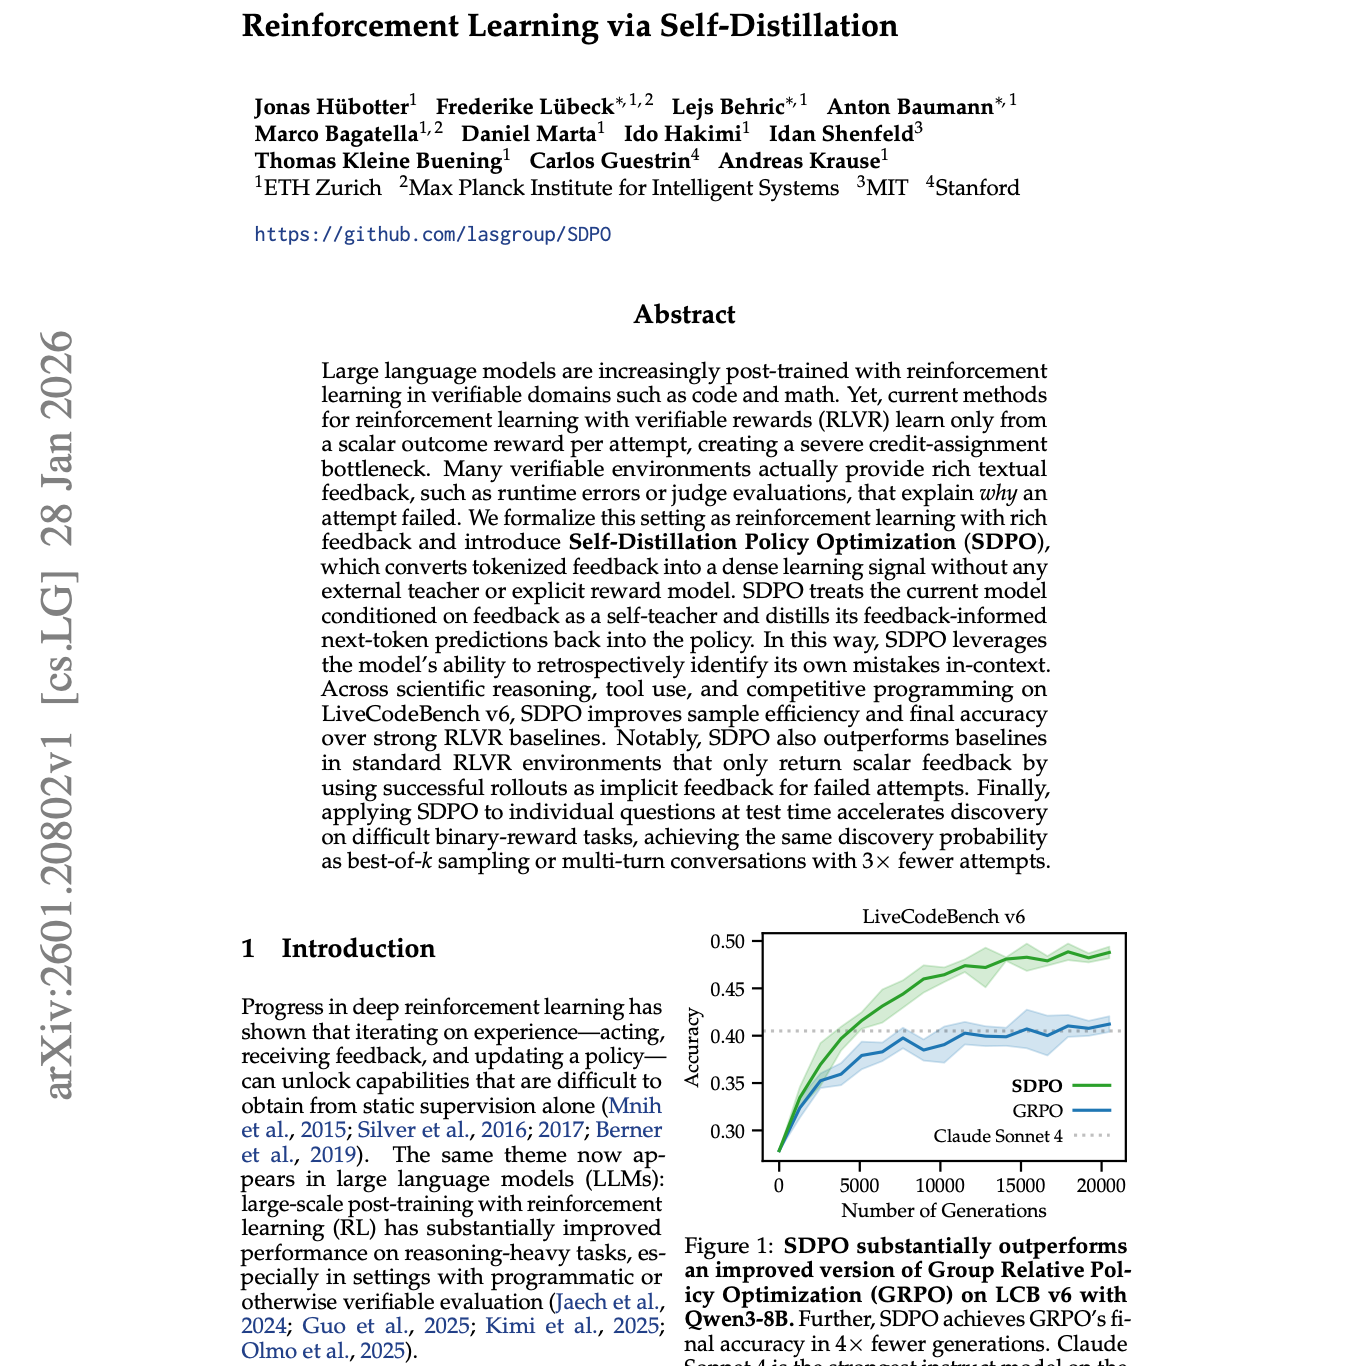
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。如果你有自己的论文要解读,或者推荐论文,请留言。今天的主题是:Reinforcement Learning via Self-DistillationSummary大型语言模型越来越多地在可验证领域(如代码与数学)中通过强化学习后训练。然而,当前用于具有可验证奖励的强化学习(RLVR)的方法通常只从每次尝试得到的单一标量结果奖励中学习,从而造成了严重的信用分配(credit assignment)瓶颈。事实上,许多可验证环境能够提供丰富的文本反馈,例如运行时错误信息或评测器(judge)的评估,这些反馈可以解释一次尝试为何失败。我们将这一设定形式化为具有丰富反馈的强化学习(reinforcement learning with rich feedback),并提出 Self-Distillation Policy Optimization(SDPO)。该方法能够在无需外部教师模型或显式奖励模型的情况下,将token 化的反馈转化为密集的学习信号。SDPO 将当前模型在给定反馈条件下的输出视为一种自教师(self-teacher),并把其基于反馈生成的下一 token 预测蒸馏回策略模型中。通过这种方式,SDPO 利用模型在上下文中事后识别自身错误的能力来进行学习。在科学推理、工具使用以及 LiveCodeBench v6 上的竞赛编程任务中,SDPO 相较于强基线 RLVR 方法,在样本效率和最终准确率方面均取得了提升。值得注意的是,在仅返回标量反馈的标准 RLVR 环境中,SDPO 仍然优于基线方法,因为它能够利用成功的 rollout 作为对失败尝试的隐式反馈。最后,当在测试时对单个问题应用 SDPO时,该方法还能加速在困难的二值奖励任务中的解发现过程:与 best-of-k 采样 或 多轮对话策略相比,SDPO 仅需 约三分之一的尝试次数就能达到相同的解发现概率。原文链接:https://arxiv.org/abs/2601.20802前往小宇宙评论区与主播互动
Embed this episode
Ready to play
【第535期】SDPO:通过自我蒸馏强化丰富反馈学习
No transcript for this episode yet
Similar Episodes
No similar episodes found.
Similar Podcasts
No similar podcasts found.