
EPISODE · Apr 7, 2026 · 21 MIN
【第555期】编码代理中 AGENTS.md 上下文文件的效用评估
from Seventy3
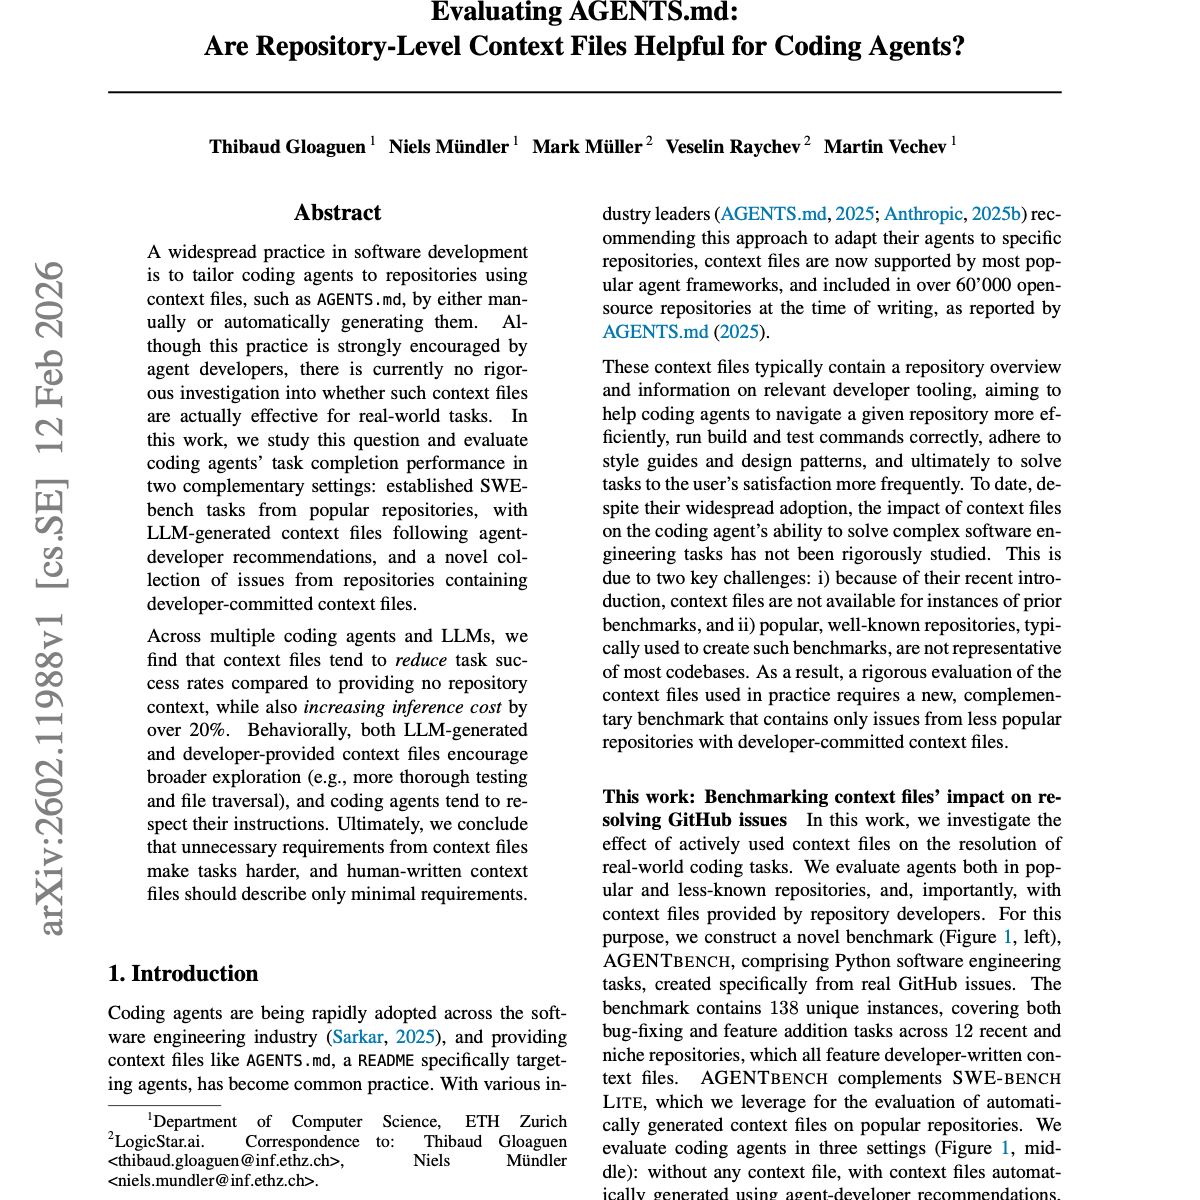
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。如果你想要解读自己的论文,获得更多曝光度。请联系小助手微信:seventy3_podcast 加群。合作邮箱:zhiwudazhanjiangshi#gmail.com今天的主题是:Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?Summary在软件开发中,一种普遍的做法是通过手动或自动生成的上下文文件(如 .cursorrules)为特定仓库量身定制编程代理(Coding Agents)。尽管代理开发者强烈鼓励这种做法,但目前尚无严谨的研究调查此类上下文文件在处理真实任务时是否真的有效。在本研究中,我们在两种互补的场景下评估了编程代理的任务完成性能: SWE-bench 任务:针对知名仓库的既有任务,根据代理开发者的建议,使用 LLM 生成上下文文件。 原创任务集:从包含开发者亲手编写(Developer-committed)的上下文文件的仓库中收集的新问题。通过对多个编程代理和 LLM 的测试,我们发现: 性能下降与成本上升:与不提供仓库上下文相比,上下文文件往往会降低任务成功率,同时增加超过 20%的推理成本。 行为影响:无论是 LLM 生成还是开发者提供的上下文文件,都会促使代理进行更广泛的探索(例如更彻底的测试和文件遍历),且编程代理倾向于遵守这些指令。最终我们得出结论:上下文文件引入的冗余要求反而增加了任务难度;因此,人工编写的上下文文件应仅描述最少限度的必要需求。原文链接:https://arxiv.org/abs/2602.11988前往小宇宙评论区与主播互动
Embed this episode
Ready to play
【第555期】编码代理中 AGENTS.md 上下文文件的效用评估
No transcript for this episode yet
Similar Episodes
No similar episodes found.
Similar Podcasts
No similar podcasts found.